Automatisation par IA
Automatisation documentaire : des factures et des e-mails aux données propres
Une grande part du temps administratif sert à ressaisir des informations qui existent déjà dans un document. L'automatisation peut les lire, mais une personne doit les valider.
Le problème de la ressaisie
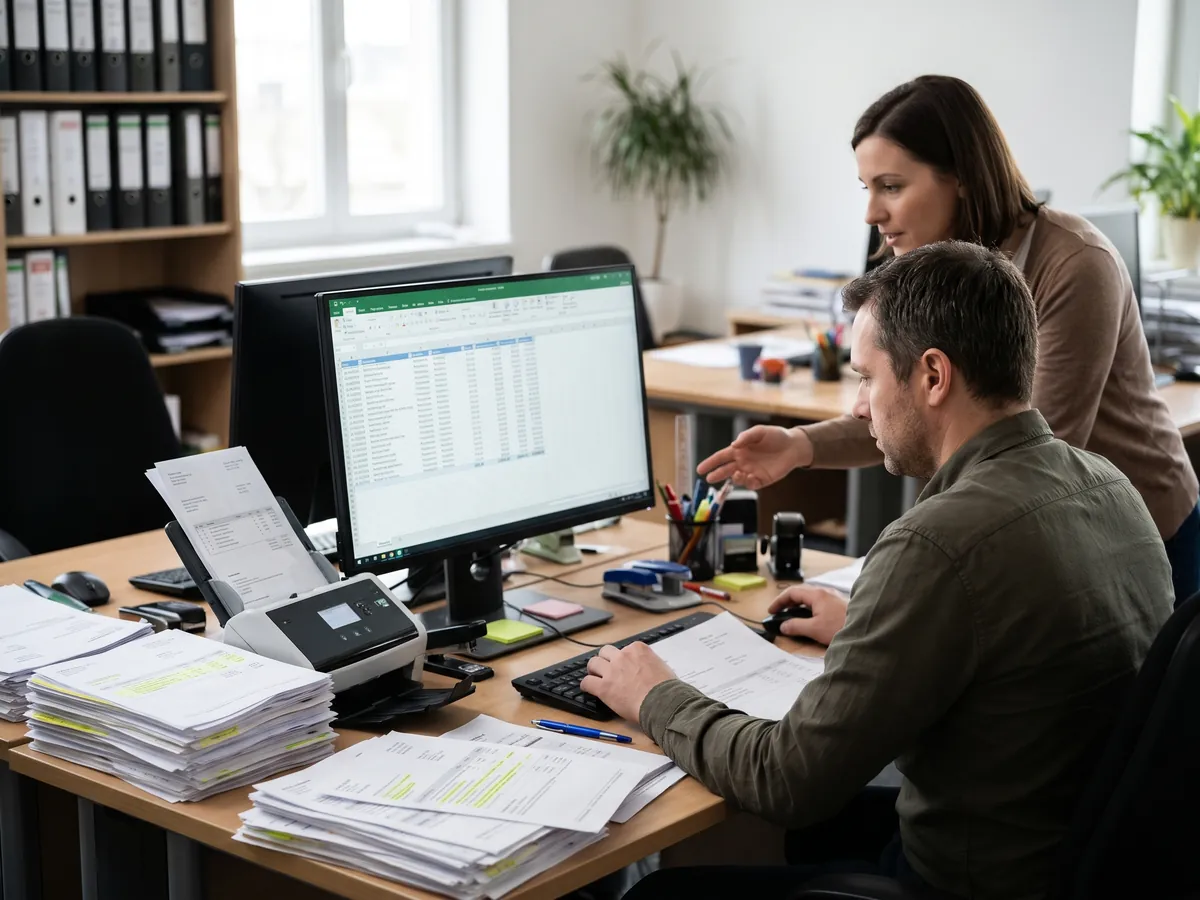
Une grande partie du travail administratif consiste à déplacer des informations d'un endroit à un autre : une facture fournisseur vers un tableau comptable, un e-mail client vers une liste de commandes, un bon de livraison vers un fichier de stock. L'information existe déjà. L'effort est dans la copie, et chaque copie est une occasion de faute de frappe.
Ce que l'automatisation fait bien
Le traitement moderne de documents peut lire un PDF ou un e-mail, repérer les champs qui vous intéressent, comme le fournisseur, la date, les lignes et les totaux, et les placer dans un tableau structuré. Comme le résultat a une forme fixe, il peut être vérifié automatiquement : les lignes totalisent-elles bien le montant, la date est-elle cohérente, le fournisseur est-il déjà connu ?
Conserver une étape de relecture
L'extraction est probabiliste ; la conception raisonnable consiste donc à mettre les résultats en attente de relecture plutôt que de les écrire directement dans vos enregistrements. Les entrées qui passent les contrôles automatiques peuvent être validées en lot, et les cas inhabituels sont signalés à une personne. Cela suit l'approche générale du cadre de gestion des risques de l'IA du NIST, un cadre volontaire qui traite l'IA comme un risque à gérer et à mesurer plutôt que comme quelque chose en quoi avoir une confiance aveugle.
À quoi cela ressemble en pratique
Un bon premier projet est étroit : un type de document, une destination, un relecteur. Chez MayTech Labs, nous construisons ce type d'automatisation sous la forme d'une petite chaîne de traitement et d'un écran de relecture simple, de sorte que le temps gagné soit visible dès la première semaine.